Đánh giá mức độ sẵn sàng dữ liệu (Data Readiness) trước khi triển khai AI tạo sinh: Hướng dẫn thực chiến với Data Lakehouse
Trong bối cảnh AI tạo sinh (Generative AI) đang trở thành ưu tiên chiến lược của mọi doanh nghiệp, một nghịch lý lớn đang diễn ra: nhiều tổ chức đổ hàng triệu USD vào các mô hình ngôn ngữ lớn (LLM) nhưng lại bỏ qua nền tảng dữ liệu. Theo báo cáo của Gartner (2024), có tới 63% doanh nghiệp triển khai AI tạo sinh thất bại trong giai đoạn thử nghiệm vì dữ liệu không đủ chất lượng, không được quản trị và thiếu khả năng truy xuất nguồn gốc. Điều này cho thấy Data Readiness – mức độ sẵn sàng của dữ liệu – không phải là yếu tố phụ mà là điều kiện tiên quyết để AI tạo sinh tạo ra giá trị thực.
Tại Uptech, qua hàng trăm dự án tư vấn và triển khai cho doanh nghiệp Việt Nam, chúng tôi nhận thấy rằng các doanh nghiệp thường mắc kẹt giữa hai thái cực: hoặc quá tập trung vào hạ tầng AI mà quên đi dữ liệu, hoặc có dữ liệu nhưng không được tổ chức theo cách mà AI có thể khai thác. Bài viết này sẽ cung cấp một hướng dẫn toàn diện, từ khung đánh giá Data Readiness, kiến trúc Data Lakehouse, đến các bài toán chi phí và lộ trình triển khai thực tế, nhằm giúp CIO/IT Lead đưa ra quyết định đầu tư đúng đắn.
Tại sao Data Readiness quyết định thành công của AI tạo sinh?
AI tạo sinh không chỉ là một mô hình ngôn ngữ; nó là một hệ thống phức tạp đòi hỏi dữ liệu đầu vào có cấu trúc, được làm sạch và có ngữ cảnh. Nếu dữ liệu đầu vào kém chất lượng, mô hình sẽ tạo ra kết quả sai lệch (hallucination) hoặc không thể trả lời chính xác các câu hỏi nghiệp vụ. Do đó, đánh giá Data Readiness giúp doanh nghiệp xác định khoảng cách giữa hiện trạng dữ liệu và yêu cầu của AI tạo sinh, từ đó có kế hoạch đầu tư hợp lý.
Khoảng cách giữa dữ liệu hiện tại và yêu cầu của AI tạo sinh
Hầu hết doanh nghiệp Việt Nam đang vận hành dữ liệu trong các silo rời rạc: ERP, CRM, hệ thống kế toán, kho vận… mỗi hệ thống có định dạng và chất lượng khác nhau. Khi tích hợp vào AI tạo sinh, các silo này tạo ra xung đột về ngữ nghĩa, thiếu tính nhất quán và không đảm bảo thời gian thực. Một cuộc khảo sát của IDC (2024) cho thấy 72% doanh nghiệp châu Á – Thái Bình Dương gặp khó khăn trong việc tích hợp dữ liệu từ nhiều nguồn để phục vụ AI, và 58% trong số đó phải mất hơn 6 tháng chỉ để làm sạch dữ liệu.
Khoảng cách này không chỉ là vấn đề kỹ thuật mà còn là vấn đề quản trị. Dữ liệu không có metadata, không được phân loại theo mức độ nhạy cảm, không có lịch sử thay đổi (lineage) sẽ khiến AI không thể truy xuất nguồn gốc, dẫn đến rủi ro tuân thủ và bảo mật. Do đó, Data Readiness cần được đánh giá trên cả khía cạnh kỹ thuật lẫn quản trị.
Chi phí ẩn của dữ liệu không sẵn sàng
Nghiên cứu của McKinsey (2023) chỉ ra rằng các doanh nghiệp phải chi thêm 30-40% ngân sách AI để khắc phục hậu quả của dữ liệu kém chất lượng, bao gồm chi phí làm sạch dữ liệu, xây dựng lại pipeline và xử lý sự cố. Đặc biệt, khi AI tạo sinh được tích hợp vào quy trình nghiệp vụ như chăm sóc khách hàng, phân tích tài chính, dữ liệu sai lệch có thể dẫn đến quyết định sai lầm và tổn thất uy tín.
Một ví dụ điển hình: một doanh nghiệp bán lẻ tại TP.HCM đã triển khai chatbot AI tạo sinh dựa trên dữ liệu sản phẩm từ CRM, nhưng do dữ liệu tồn kho không được đồng bộ thời gian thực, chatbot liên tục tư vấn sai về tình trạng còn hàng, dẫn đến tỷ lệ hủy đơn tăng 25%. Sau khi Uptech tư vấn và triển khai Data Lakehouse với khả năng streaming, tỷ lệ này giảm xuống còn 3%. Đây là minh chứng rõ ràng cho việc đầu tư vào Data Readiness mang lại hiệu quả tài chính trực tiếp.
Khung đánh giá Data Readiness 5 chiều
Để đánh giá một cách hệ thống, Uptech đề xuất khung 5 chiều dựa trên kinh nghiệm thực chiến và các tiêu chuẩn quốc tế như DAMA-DMBOK và ISO 8000. Khung này giúp doanh nghiệp có cái nhìn toàn cảnh về mức độ sẵn sàng của dữ liệu trước khi đầu tư vào AI tạo sinh.
Chất lượng dữ liệu (Accuracy, Completeness, Consistency)
Chất lượng dữ liệu là yếu tố nền tảng. AI tạo sinh yêu cầu dữ liệu phải chính xác, đầy đủ và nhất quán trên các hệ thống. Một nghiên cứu của Harvard Business Review (2023) cho thấy 47% nhà lãnh đạo doanh nghiệp không tin tưởng vào chất lượng dữ liệu của chính mình. Để đánh giá, doanh nghiệp cần đo lường các chỉ số như tỷ lệ bản ghi thiếu (missing rate), tỷ lệ trùng lặp (duplicate rate), và tỷ lệ sai lệch so với nguồn gốc (accuracy rate).
Uptech khuyến nghị áp dụng các công cụ profiling dữ liệu tự động để thiết lập baseline và theo dõi liên tục. Trong một dự án cho khách hàng ngành tài chính, chúng tôi đã phát hiện 18% bản ghi khách hàng bị trùng lặp và 12% thiếu thông tin liên hệ, ảnh hưởng trực tiếp đến khả năng cá nhân hóa của AI. Sau khi làm sạch và thiết lập quy trình kiểm soát, tỷ lệ này giảm xuống dưới 2%.
Quản trị dữ liệu và bảo mật
Quản trị dữ liệu bao gồm việc xác định quyền sở hữu, phân loại dữ liệu, và thiết lập chính sách truy cập. Với AI tạo sinh, dữ liệu nhạy cảm như thông tin khách hàng, dữ liệu tài chính cần được bảo vệ nghiêm ngặt. Tuân thủ ISO 27001 không chỉ là yêu cầu pháp lý mà còn là yếu tố tạo niềm tin cho khách hàng và đối tác. Uptech đã tích hợp các tiêu chuẩn bảo mật này vào kiến trúc Data Lakehouse, đảm bảo dữ liệu được mã hóa cả khi lưu trữ và truyền tải.
Bên cạnh đó, việc thiếu metadata và lineage khiến việc kiểm toán dữ liệu trở nên khó khăn. Doanh nghiệp cần xây dựng một catalog dữ liệu tập trung, nơi mọi trường dữ liệu được mô tả, gắn thẻ và theo dõi nguồn gốc. Điều này không chỉ hỗ trợ AI mà còn giúp các nhóm phân tích và tuân thủ dễ dàng hơn.
Kiến trúc Data Lakehouse – nền tảng cho AI tạo sinh
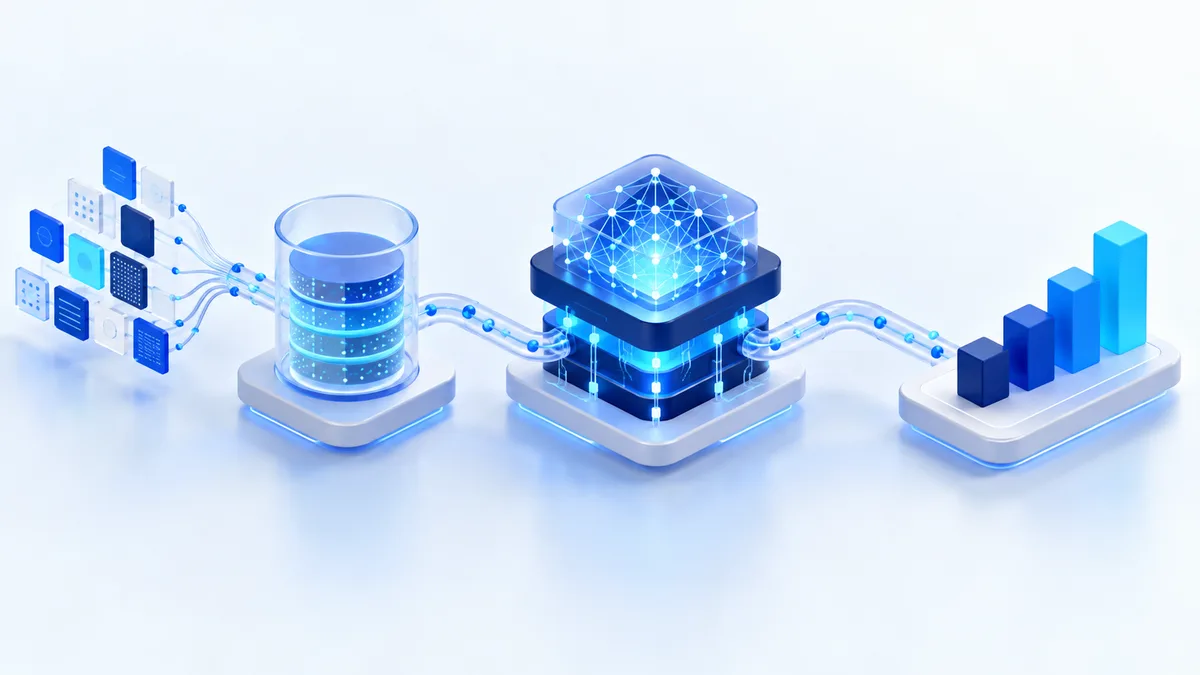
Data Lakehouse là kiến trúc kết hợp ưu điểm của Data Lake (khả năng lưu trữ linh hoạt, chi phí thấp) và Data Warehouse (khả năng truy vấn hiệu suất cao, quản trị chặt chẽ). Đây là nền tảng lý tưởng để chuẩn bị dữ liệu cho AI tạo sinh, vì nó cho phép xử lý cả dữ liệu có cấu trúc và phi cấu trúc, đồng thời hỗ trợ các mô hình học máy và phân tích thời gian thực.
Các thành phần cơ bản của Data Lakehouse
Một Data Lakehouse hiện đại bao gồm: lớp lưu trữ (thường là object storage như S3, ADLS), lớp định dạng bảng mở (Delta Lake, Apache Iceberg, Hudi), lớp catalog (Unity Catalog, AWS Glue), và lớp compute (Spark, Presto, hoặc các engine serverless). Kiến trúc này cho phép doanh nghiệp lưu trữ dữ liệu thô từ nhiều nguồn, sau đó tổ chức thành các bảng có schema rõ ràng, hỗ trợ ACID transactions và time travel – những tính năng quan trọng để đảm bảo tính nhất quán cho AI.
Điểm mạnh của Data Lakehouse là khả năng mở rộng và tích hợp. Uptech đã triển khai kiến trúc này cho một khách hàng sản xuất với hàng chục hệ thống ERP và CRM, cho phép họ kết hợp dữ liệu từ nhà máy, chuỗi cung ứng và bán hàng để huấn luyện mô hình dự báo nhu cầu, đạt độ chính xác 92% – cao hơn 15% so với phương pháp truyền thống.
Tích hợp ERP/CRM an toàn và hiệu quả
ERP và CRM là hai nguồn dữ liệu quan trọng nhất trong doanh nghiệp, nhưng việc tích hợp chúng vào Data Lakehouse thường gặp thách thức về hiệu suất và bảo mật. Uptech áp dụng phương pháp tiếp cận dựa trên change data capture (CDC) để đồng bộ dữ liệu theo thời gian thực mà không gây tải lên hệ thống nguồn. Đồng thời, chúng tôi thiết lập các lớp kiểm soát truy cập dựa trên vai trò (RBAC) và mã hóa dữ liệu nhạy cảm trước khi đưa vào lakehouse.
Với kinh nghiệm tích hợp SAP, Oracle, Salesforce và các hệ thống nội địa, Uptech đảm bảo quá trình tích hợp diễn ra an toàn, tuân thủ ISO 27001 và không làm gián đoạn vận hành. Chúng tôi cũng cung cấp các connector tùy chỉnh cho những hệ thống legacy, giúp doanh nghiệp tận dụng tối đa dữ liệu hiện có.
Tối ưu và đồng hành cùng chuyên gia Uptech
Uptech cung cấp dịch vụ AI & Đổi mới Dữ liệu trọn gói, cam kết SLA và tối ưu chi phí vận hành.
Nhận tư vấn giải pháp
Lộ trình triển khai Data Readiness thực chiến
Dựa trên kinh nghiệm tư vấn cho nhiều doanh nghiệp, Uptech đã đúc kết lộ trình 4 giai đoạn giúp đánh giá và cải thiện Data Readiness một cách có hệ thống, từ đó tạo tiền đề vững chắc cho AI tạo sinh.
Giai đoạn 1: Đánh giá hiện trạng (Assessment)
Giai đoạn này tập trung vào việc kiểm kê toàn bộ nguồn dữ liệu, đánh giá chất lượng và xác định các rào cản. Uptech sử dụng bộ công cụ profiling tự động để thu thập số liệu về độ đầy đủ, tính nhất quán và mức độ trùng lặp. Kết quả là một báo cáo chi tiết về điểm số Data Readiness theo từng chiều, giúp doanh nghiệp biết mình đang ở đâu.
Thời gian trung bình cho giai đoạn này là 2-4 tuần, tùy quy mô dữ liệu. Chi phí đầu tư thường chỉ bằng 5-10% so với chi phí khắc phục hậu quả sau này, theo ước tính của Uptech từ các dự án đã thực hiện.
Giai đoạn 2: Xây dựng nền tảng (Foundation)
Dựa trên kết quả đánh giá, doanh nghiệp cần xây dựng hoặc nâng cấp hạ tầng dữ liệu, bao gồm Data Lakehouse, catalog và các pipeline tích hợp. Uptech hỗ trợ triển khai kiến trúc phân tán mở, cho phép mở rộng linh hoạt và tích hợp an toàn với ERP/CRM. Chúng tôi cũng thiết lập các quy trình quản trị dữ liệu, bao gồm phân loại, gắn thẻ và kiểm soát truy cập.
Trong giai đoạn này, việc lựa chọn công nghệ phù hợp là rất quan trọng. Uptech tư vấn cho khách hàng lựa chọn giữa các nền tảng như Databricks, Snowflake, hoặc các giải pháp mã nguồn mở như Apache Iceberg, dựa trên nhu cầu cụ thể và ngân sách.
Bài toán chi phí và rủi ro khi đầu tư AI tạo sinh
Đầu tư vào AI tạo sinh không chỉ là chi phí mua license mô hình mà còn là chi phí chuẩn bị dữ liệu, tích hợp hệ thống và vận hành. Nếu không đánh giá đúng Data Readiness, doanh nghiệp có thể đối mặt với chi phí phát sinh ngoài dự kiến và rủi ro thất bại.
Phân tích chi phí tổng thể (TCO)
Theo nghiên cứu của Gartner (2024), chi phí chuẩn bị dữ liệu chiếm tới 60-70% tổng chi phí triển khai AI tạo sinh trong năm đầu tiên. Tuy nhiên, nếu doanh nghiệp đã có nền tảng Data Lakehouse và quy trình quản trị dữ liệu tốt, chi phí này có thể giảm xuống còn 30-40%. Uptech đã giúp một khách hàng ngành bảo hiểm tiết kiệm 35% chi phí bằng cách tận dụng kiến trúc lakehouse hiện có và chỉ bổ sung các thành phần cần thiết.
Bên cạnh chi phí trực tiếp, cần tính đến chi phí cơ hội và rủi ro tuân thủ. Dữ liệu không được quản trị có thể dẫn đến vi phạm quy định bảo vệ dữ liệu cá nhân (như Nghị định 13/2023/NĐ-CP tại Việt Nam), gây phạt tiền và tổn hại danh tiếng.
Các rủi ro thường gặp và cách giảm thiểu
Rủi ro lớn nhất là triển khai AI trên dữ liệu chưa được kiểm chứng, dẫn đến kết quả sai lệch và mất niềm tin từ người dùng. Để giảm thiểu, Uptech khuyến nghị áp dụng quy trình kiểm thử dữ liệu nghiêm ngặt trước khi đưa vào mô hình, đồng thời thiết lập cơ chế giám sát liên tục và phản hồi từ người dùng. Một rủi ro khác là thiếu kỹ năng nội bộ để vận hành và bảo trì hệ thống dữ liệu phức tạp; do đó, việc đào tạo và chuyển giao kiến thức là phần không thể thiếu trong mọi dự án của Uptech.
So sánh các phương án triển khai
Để giúp doanh nghiệp có cái nhìn trực quan, bảng dưới đây so sánh các phương án truyền thống và giải pháp khuyến nghị của Uptech dựa trên các tiêu chí quan trọng.
| Tiêu chí | Mô hình truyền thống | Thách thức thường gặp | Giải pháp khuyến nghị (Uptech) |
|---|---|---|---|
| Kiến trúc dữ liệu | Data Warehouse hoặc Data Lake riêng lẻ | Khó tích hợp dữ liệu phi cấu trúc, chi phí mở rộng cao | Data Lakehouse với Delta Lake/Iceberg, hỗ trợ đa dạng định dạng |
| Tích hợp ERP/CRM | Batch ETL định kỳ, có độ trễ | Dữ liệu không real-time, ảnh hưởng đến AI | CDC streaming, tích hợp an toàn, tuân thủ ISO 27001 |
| Quản trị dữ liệu | Thủ công, thiếu catalog tập trung | Khó truy xuất nguồn gốc, rủi ro tuân thủ | Catalog tự động, lineage, phân loại dữ liệu theo chính sách |
| Chi phí vận hành | Cao do silo và trùng lặp | Tốn kém, khó dự báo | Tối ưu chi phí nhờ kiến trúc mở, serverless compute |
| Bảo mật | Kiểm soát truy cập cơ bản | Dễ bị rò rỉ dữ liệu nhạy cảm | Mã hóa end-to-end, RBAC, tuân thủ ISO 27001 |
Bảng so sánh cho thấy rõ lợi ích của việc áp dụng kiến trúc Data Lakehouse và các giải pháp quản trị dữ liệu hiện đại. Tuy nhiên, để thành công, doanh nghiệp cần có lộ trình phù hợp và đối tác giàu kinh nghiệm như Uptech.
Câu hỏi thường gặp
Data Readiness là gì và tại sao cần đánh giá trước khi triển khai AI tạo sinh?
Data Readiness là mức độ sẵn sàng của dữ liệu để đáp ứng yêu cầu của AI tạo sinh, bao gồm chất lượng, quản trị, bảo mật và khả năng tích hợp. Đánh giá trước giúp doanh nghiệp xác định khoảng cách, tránh đầu tư lãng phí và giảm rủi ro thất bại. Theo Gartner, 63% dự án AI tạo sinh thất bại vì dữ liệu không sẵn sàng.
Data Lakehouse khác gì so với Data Warehouse truyền thống?
Data Lakehouse kết hợp khả năng lưu trữ linh hoạt của Data Lake với hiệu suất truy vấn và quản trị của Data Warehouse. Nó hỗ trợ cả dữ liệu có cấu trúc và phi cấu trúc, cho phép AI tạo sinh khai thác tối đa nguồn dữ liệu đa dạng. Ngoài ra, Lakehouse hỗ trợ ACID transactions và time travel, đảm bảo tính nhất quán.
Làm thế nào để tích hợp ERP/CRM vào Data Lakehouse một cách an toàn?
Uptech sử dụng phương pháp CDC để đồng bộ dữ liệu real-time mà không gây tải lên hệ thống nguồn, kết hợp với mã hóa dữ liệu và kiểm soát truy cập dựa trên vai trò. Chúng tôi tuân thủ tiêu chuẩn ISO 27001 trong suốt quá trình tích hợp, đảm bảo an toàn cho dữ liệu nhạy cảm.
Chi phí để đánh giá và cải thiện Data Readiness là bao nhiêu?
Chi phí phụ thuộc vào quy mô dữ liệu và mức độ phức tạp của hệ thống. Thông thường, giai đoạn đánh giá chiếm 5-10% tổng ngân sách dự án AI, nhưng giúp tiết kiệm 30-40% chi phí khắc phục sau này. Uptech cung cấp dịch vụ tư vấn linh hoạt theo nhu cầu và ngân sách của doanh nghiệp.
Để được tư vấn chi tiết về đánh giá Data Readiness và giải pháp Data Lakehouse phù hợp, vui lòng liên hệ Uptech hoặc tham khảo dịch vụ AI & Đổi mới Dữ liệu của chúng tôi.