RAG Pipeline kết hợp AI Agents giúp doanh nghiệp khai thác dữ liệu nội bộ an toàn bằng cách truy xuất ngữ cảnh từ kho tri thức riêng trước khi sinh câu trả lời. Uptech thiết kế kiến trúc dữ liệu phân tán mở, tích hợp ERP/CRM và tuân thủ ISO 27001, giảm rủi ro ảo giác và rò rỉ dữ liệu.
Trong bối cảnh các mô hình ngôn ngữ lớn (LLM) ngày càng phổ biến, doanh nghiệp Việt Nam đang đối mặt với một nghịch lý: muốn tận dụng AI để tăng năng suất nhưng lại lo ngại dữ liệu nội bộ bị rò rỉ hoặc câu trả lời thiếu chính xác. Theo khảo sát của Gartner năm 2024, hơn 60% tổ chức triển khai AI tạo sinh sẽ ưu tiên các giải pháp dựa trên dữ liệu riêng thay vì mô hình công cộng. Đây chính là lý do RAG Pipeline (Retrieval-Augmented Generation) trở thành xương sống của chiến lược AI an toàn. Bài viết này phân tích chi tiết cách xây dựng RAG Pipeline kết hợp AI Agents cho dữ liệu nội bộ, từ kiến trúc kỹ thuật đến bài toán chi phí và tuân thủ bảo mật.
Tại sao RAG Pipeline là xương sống của AI doanh nghiệp?
RAG Pipeline không chỉ là một kỹ thuật tạm thời để giảm ảo giác (hallucination) mà đã trở thành kiến trúc tham chiếu cho mọi ứng dụng AI doanh nghiệp cần độ chính xác và khả năng truy vết. Theo báo cáo của McKinsey (2024), các tổ chức sử dụng RAG cho ứng dụng nội bộ ghi nhận mức giảm 40-60% lỗi thông tin so với việc chỉ dùng LLM thuần túy. Điều này đặc biệt quan trọng trong các lĩnh vực như tài chính, pháp lý và sản xuất, nơi một câu trả lời sai có thể gây thiệt hại lớn.
Định nghĩa và vai trò của RAG trong hệ sinh thái AI
RAG Pipeline là quy trình kết hợp hai giai đoạn: truy xuất (retrieval) các đoạn văn bản liên quan từ kho tri thức nội bộ và sinh (generation) câu trả lời dựa trên ngữ cảnh đã truy xuất. Thay vì phụ thuộc vào kiến thức tĩnh của mô hình, RAG cho phép hệ thống cập nhật thông tin theo thời gian thực từ tài liệu, cơ sở dữ liệu và hệ thống ERP/CRM. Vai trò của RAG là cầu nối giữa dữ liệu doanh nghiệp và khả năng suy luận của LLM, đảm bảo câu trả lời vừa chính xác vừa có thể trích dẫn nguồn.
Trong kiến trúc tổng thể, RAG Pipeline đóng vai trò như một lớp trung gian bảo mật: dữ liệu nhạy cảm không bao giờ được gửi trực tiếp vào mô hình mà chỉ những đoạn ngữ cảnh đã được kiểm soát mới được đưa vào prompt. Điều này giúp doanh nghiệp duy trì quyền kiểm soát dữ liệu, đồng thời vẫn tận dụng được sức mạnh của các mô hình ngôn ngữ tiên tiến. Uptech thường thiết kế RAG Pipeline theo hướng module hóa, cho phép thay thế từng thành phần (embedding model, vector store, LLM) mà không ảnh hưởng đến toàn bộ hệ thống.
So sánh RAG với fine-tuning và khi nào nên chọn RAG
Fine-tuning là quá trình huấn luyện lại mô hình trên dữ liệu chuyên ngành, trong khi RAG truy xuất ngữ cảnh tại thời điểm truy vấn. Fine-tuning phù hợp khi doanh nghiệp cần mô hình hiểu phong cách viết hoặc thuật ngữ chuyên sâu, nhưng chi phí cao và khó cập nhật. RAG linh hoạt hơn, cho phép cập nhật kho tri thức hàng ngày mà không cần huấn luyện lại, đồng thời giảm nguy cơ mô hình ghi nhớ thông tin nhạy cảm. Theo IDC (2024), 70% doanh nghiệp lựa chọn RAG cho các ứng dụng hỏi đáp nội bộ vì thời gian triển khai nhanh và chi phí vận hành thấp hơn.
Tuy nhiên, RAG không phải là giải pháp thay thế hoàn toàn cho fine-tuning. Trong nhiều trường hợp, kiến trúc lai (hybrid) kết hợp RAG và fine-tuning mang lại hiệu quả tốt nhất: fine-tuning giúp mô hình hiểu ngữ cảnh chuyên ngành, còn RAG đảm bảo tính thời sự và khả năng trích dẫn. Uptech khuyến nghị doanh nghiệp bắt đầu với RAG để nhanh chóng có kết quả, sau đó đánh giá nhu cầu fine-tuning dựa trên các chỉ số như độ chính xác và mức độ hài lòng của người dùng.
Kiến trúc RAG Pipeline cho dữ liệu nội bộ doanh nghiệp
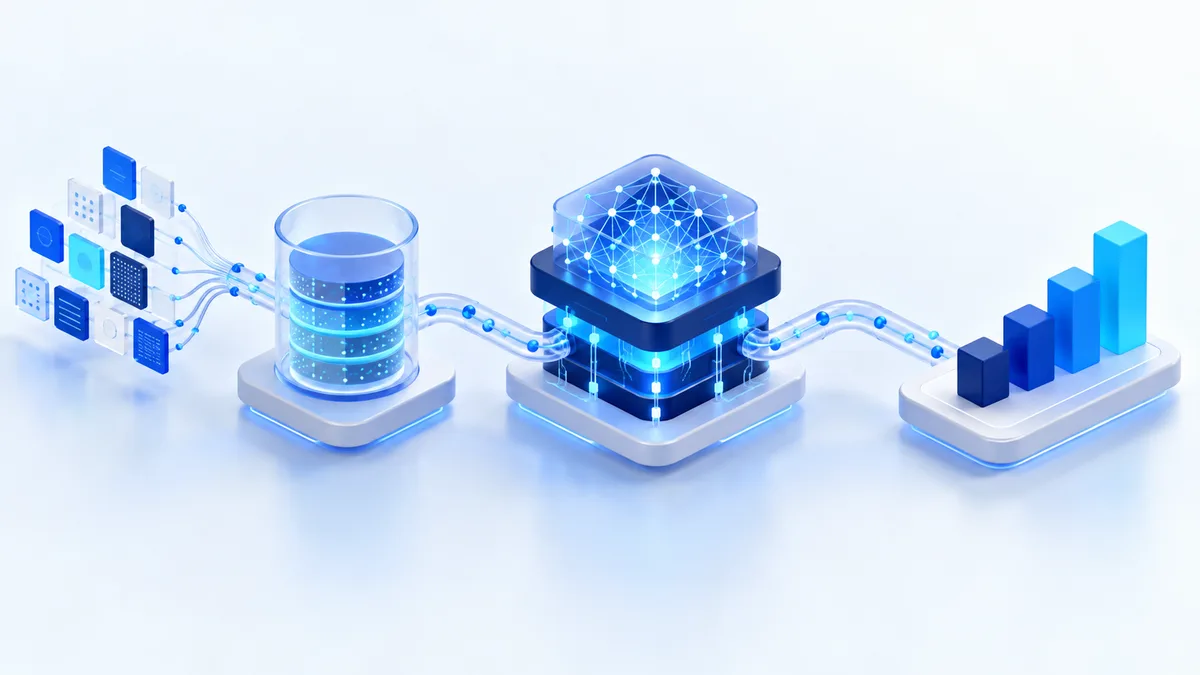
Một RAG Pipeline hiệu quả cho dữ liệu nội bộ cần được thiết kế như một hệ thống phân tán, có khả năng mở rộng và tích hợp với các hệ thống hiện hữu. Kiến trúc tham chiếu của Uptech bao gồm năm lớp chính: thu thập dữ liệu, tiền xử lý và chunking, lưu trữ vector, truy xuất và sinh câu trả lời. Mỗi lớp đều có yêu cầu riêng về bảo mật và hiệu năng, đặc biệt khi tích hợp với ERP/CRM.
Các thành phần cốt lõi: ingestion, chunking, embedding, vector store
Lớp ingestion chịu trách nhiệm thu thập dữ liệu từ nhiều nguồn khác nhau như tài liệu PDF, email, cơ sở dữ liệu quan hệ, API của ERP/CRM. Dữ liệu sau đó được chuẩn hóa và phân đoạn (chunking) thành các đơn vị nhỏ có ngữ nghĩa, thường từ 200-500 token, để tối ưu cho việc truy xuất. Chunking chất lượng cao là yếu tố then chốt: nếu chunk quá lớn, thông tin nhiễu sẽ làm giảm độ chính xác; nếu quá nhỏ, ngữ cảnh bị mất.
Embedding là quá trình chuyển đổi văn bản thành vector số học, cho phép tìm kiếm tương đồng ngữ nghĩa. Doanh nghiệp có thể lựa chọn embedding model thương mại như OpenAI text-embedding-3 hoặc mã nguồn mở như BGE-M3 để cân bằng giữa chi phí và chất lượng. Vector store (như Pinecone, Weaviate, Qdrant hoặc Milvus) lưu trữ và chỉ mục các vector, hỗ trợ truy vấn nhanh với hàng triệu vector. Uptech thường tư vấn triển khai vector store trong hạ tầng riêng hoặc VPC để đảm bảo dữ liệu không rời khỏi môi trường kiểm soát.
Tích hợp an toàn với ERP/CRM và hệ thống nội bộ
Tích hợp RAG Pipeline với ERP/CRM là thách thức lớn nhất trong triển khai thực tế. Các hệ thống này thường có API hạn chế, dữ liệu phân mảnh và yêu cầu bảo mật cao. Uptech áp dụng kiến trúc dữ liệu phân tán mở, sử dụng các connector chuyên dụng để đồng bộ dữ liệu theo thời gian thực hoặc theo lô, đồng thời mã hóa dữ liệu cả khi truyền và khi lưu trữ. Các connector này được thiết kế để chỉ đọc (read-only) và tuân thủ phân quyền của hệ thống nguồn, đảm bảo người dùng chỉ truy xuất được dữ liệu mà họ có quyền xem.
Một điểm quan trọng là cơ chế kiểm soát truy cập dựa trên vai trò (RBAC) và ghi nhật ký kiểm toán (audit logging) cho mọi truy vấn. Khi người dùng đặt câu hỏi, RAG Pipeline sẽ kiểm tra quyền của họ trước khi truy xuất dữ liệu từ ERP/CRM, đảm bảo không rò rỉ thông tin nhạy cảm như lương, hợp đồng hoặc dữ liệu khách hàng. Uptech đã triển khai thành công cho một doanh nghiệp sản xuất với hơn 2.000 người dùng, tích hợp SAP và Salesforce, giảm thời gian tra cứu thông tin từ 15 phút xuống còn 30 giây.
AI Agents và tự động hóa quy trình với RAG Pipeline
AI Agents là bước tiến tiếp theo của RAG Pipeline, cho phép hệ thống không chỉ trả lời câu hỏi mà còn thực hiện hành động tự động. Thay vì chỉ truy xuất và sinh văn bản, AI Agents có thể gọi API, cập nhật CRM, tạo báo cáo hoặc gửi email dựa trên ngữ cảnh. Điều này mở ra tiềm năng tự động hóa quy trình nghiệp vụ phức tạp, nhưng cũng đặt ra yêu cầu cao về kiểm soát và giám sát.
Kiến trúc Agent: planning, tool use, memory và guardrails
Một AI Agent hiệu quả cần bốn thành phần: planning (lập kế hoạch), tool use (sử dụng công cụ), memory (bộ nhớ) và guardrails (rào chắn an toàn). Planning cho phép agent phân rã nhiệm vụ phức tạp thành các bước nhỏ, trong khi tool use cho phép agent gọi các API nội bộ như tra cứu tồn kho, tính giá hoặc tạo hóa đơn. Memory giúp agent ghi nhớ ngữ cảnh hội thoại và kết quả trung gian, còn guardrails đảm bảo agent không thực hiện hành động nguy hiểm ngoài phạm vi cho phép.
Uptech thiết kế AI Agents theo mô hình human-in-the-loop: các hành động có tác động lớn như cập nhật dữ liệu tài chính hoặc gửi hợp đồng đều yêu cầu phê duyệt của con người. Đồng thời, mọi hành động của agent được ghi log đầy đủ để phục vụ kiểm toán và truy vết. Theo Gartner (2024), đến năm 2026, 30% doanh nghiệp sẽ triển khai AI Agents cho ít nhất một quy trình nghiệp vụ, nhưng chỉ những tổ chức có guardrails chặt chẽ mới đạt được ROI kỳ vọng.
Các tình huống sử dụng điển hình: chăm sóc khách hàng, tài chính, nhân sự
Trong chăm sóc khách hàng, AI Agent có thể truy xuất lịch sử tương tác từ CRM, tra cứu chính sách bảo hành và đề xuất giải pháp, sau đó tự động tạo ticket hoặc chuyển cấp nếu cần. Trong tài chính, agent hỗ trợ đối soát hóa đơn, phát hiện bất thường và chuẩn bị báo cáo tháng dựa trên dữ liệu từ ERP. Trong nhân sự, agent trả lời câu hỏi về chính sách lương thưởng, quy trình nghỉ phép và hỗ trợ onboarding nhân viên mới.
Một khách hàng của Uptech trong lĩnh vực bán lẻ đã triển khai AI Agent cho bộ phận chăm sóc khách hàng, giảm 45% thời gian xử lý yêu cầu và tăng 20% mức độ hài lòng của khách hàng. Điều quan trọng là agent được huấn luyện để trả lời dựa trên kho tri thức nội bộ đã được kiểm duyệt, tránh đưa ra thông tin sai lệch về sản phẩm hoặc chính sách. Uptech cung cấp giải pháp AI & Đổi mới Dữ liệu trọn gói, từ tư vấn kiến trúc đến vận hành và giám sát.
Tối ưu và đồng hành cùng chuyên gia Uptech
Uptech cung cấp dịch vụ AI & Đổi mới Dữ liệu trọn gói, cam kết SLA và tối ưu chi phí vận hành.
Nhận tư vấn giải pháp
Bảo mật, tuân thủ và quản trị dữ liệu trong RAG Pipeline
Bảo mật là yếu tố sống còn khi triển khai RAG Pipeline cho dữ liệu nội bộ. Doanh nghiệp cần đảm bảo dữ liệu không bị rò rỉ qua prompt, không bị lưu trữ ngoài kiểm soát và tuân thủ các quy định như Nghị định 13/2023/NĐ-CP về bảo vệ dữ liệu cá nhân. Uptech áp dụng tiêu chuẩn ISO 27001 trong toàn bộ vòng đời dự án, từ đánh giá rủi ro đến kiểm soát truy cập và mã hóa.
Mã hóa dữ liệu và kiểm soát truy cập
Dữ liệu trong RAG Pipeline cần được mã hóa cả khi truyền (TLS 1.3) và khi lưu trữ (AES-256). Vector store và cơ sở dữ liệu metadata phải được triển khai trong môi trường mạng riêng, với tường lửa và phân vùng bảo mật rõ ràng. Kiểm soát truy cập dựa trên vai trò (RBAC) và nguyên tắc đặc quyền tối thiểu (least privilege) đảm bảo chỉ những người có thẩm quyền mới được truy cập dữ liệu nhạy cảm. Ngoài ra, doanh nghiệp nên triển khai xoay vòng khóa (key rotation) định kỳ và giám sát bất thường.
Một giải pháp quan trọng là che giấu dữ liệu (data masking) trước khi đưa vào prompt, đặc biệt với thông tin cá nhân như số điện thoại, email, số CMND. Uptech tích hợp lớp tiền xử lý để tự động phát hiện và ẩn danh các trường thông tin nhạy cảm, chỉ giữ lại ngữ cảnh cần thiết cho câu trả lời. Điều này giúp giảm thiểu rủi ro tuân thủ mà vẫn đảm bảo chất lượng câu trả lời.
Giám sát, ghi log và kiểm toán mô hình
Hệ thống RAG Pipeline cần có khả năng ghi log mọi truy vấn, ngữ cảnh truy xuất và câu trả lời để phục vụ kiểm toán và điều tra sự cố. Log cần được lưu trữ an toàn, có thời hạn lưu trữ theo quy định và chỉ những người có thẩm quyền mới được truy cập. Uptech triển khai dashboard giám sát theo thời gian thực các chỉ số như độ trễ, tỷ lệ lỗi, số lượng truy vấn và mức độ hài lòng của người dùng.
Kiểm toán mô hình (model audit) là quy trình đánh giá định kỳ chất lượng câu trả lời, phát hiện thiên lệch (bias) và cập nhật kho tri thức. Doanh nghiệp nên thiết lập quy trình đánh giá tự động bằng các bộ dữ liệu kiểm thử (test set) và đánh giá thủ công bởi chuyên gia. Uptech cung cấp dịch vụ đánh giá và tối ưu RAG Pipeline định kỳ, giúp doanh nghiệp duy trì chất lượng và tuân thủ trong suốt vòng đời hệ thống.
Bài toán chi phí và ROI khi triển khai RAG Pipeline
Chi phí triển khai RAG Pipeline bao gồm chi phí hạ tầng, chi phí mô hình và chi phí vận hành. Hạ tầng bao gồm vector store, máy chủ xử lý và lưu trữ dữ liệu; chi phí mô hình bao gồm embedding và LLM inference; chi phí vận hành bao gồm nhân sự giám sát và bảo trì. Theo tính toán của Uptech, một hệ thống RAG Pipeline cho 500 người dùng có thể tốn từ 1.500 đến 3.000 USD/tháng tùy thuộc vào lựa chọn mô hình và hạ tầng.
Các yếu tố ảnh hưởng đến chi phí: mô hình, hạ tầng, dữ liệu
Lựa chọn mô hình ảnh hưởng lớn đến chi phí: các mô hình thương mại như GPT-4o có chi phí cao hơn nhưng chất lượng tốt, trong khi các mô hình mã nguồn mở như Llama 3 có thể giảm chi phí đáng kể nếu doanh nghiệp có hạ tầng GPU. Chi phí embedding cũng cần được tính đến, đặc biệt khi kho tri thức lớn và cần cập nhật thường xuyên. Uptech tư vấn doanh nghiệp lựa chọn mô hình phù hợp với ngân sách và yêu cầu chất lượng, đồng thời tối ưu hóa chunking và caching để giảm số lượng token tiêu thụ.
Hạ tầng có thể được triển khai trên cloud (AWS, Azure, GCP) hoặc on-premise. Cloud mang lại tính linh hoạt và khả năng mở rộng, nhưng chi phí có thể tăng theo lưu lượng. On-premise phù hợp với doanh nghiệp có yêu cầu bảo mật cao và muốn kiểm soát hoàn toàn dữ liệu, nhưng đòi hỏi đầu tư ban đầu lớn. Uptech hỗ trợ doanh nghiệp đánh giá và lựa chọn mô hình triển khai phù hợp với chiến lược dài hạn.
Cách tối ưu ROI và lộ trình triển khai theo giai đoạn
Để tối ưu ROI, doanh nghiệp nên triển khai RAG Pipeline theo giai đoạn: giai đoạn 1 tập trung vào một phòng ban hoặc quy trình cụ thể để nhanh chóng có kết quả; giai đoạn 2 mở rộng sang các phòng ban khác và tích hợp thêm hệ thống; giai đoạn 3 tự động hóa bằng AI Agents và tối ưu hóa chi phí. Lộ trình này giúp doanh nghiệp kiểm soát rủi ro và điều chỉnh chiến lược dựa trên phản hồi thực tế.
Uptech đã đồng hành cùng nhiều doanh nghiệp Việt Nam trong việc triển khai RAG Pipeline, từ các công ty sản xuất đến tổ chức tài chính. Một khách hàng trong lĩnh vực logistics đã giảm 35% chi phí vận hành nhờ tự động hóa quy trình tra cứu và xử lý chứng từ. Để được tư vấn chi tiết về lộ trình phù hợp, doanh nghiệp có thể liên hệ Uptech để được chuyên gia phân tích và đề xuất giải pháp tối ưu.
Bảng so sánh: Mô hình truyền thống và RAG Pipeline
| Tiêu chí | Mô hình truyền thống | Thách thức thường gặp | Giải pháp khuyến nghị (Uptech) |
|---|---|---|---|
| Độ chính xác câu trả lời | Phụ thuộc vào kiến thức tĩnh của mô hình, dễ sai lệch | Ảo giác (hallucination) cao, thiếu trích dẫn nguồn | RAG Pipeline truy xuất ngữ cảnh từ kho tri thức nội bộ, giảm 40-60% lỗi |
| Bảo mật dữ liệu | Dữ liệu gửi trực tiếp vào mô hình công cộng | Rò rỉ thông tin nhạy cảm, vi phạm quy định | Kiến trúc phân tán, mã hóa AES-256, RBAC, tuân thủ ISO 27001 |
| Khả năng cập nhật | Phải huấn luyện lại mô hình, tốn thời gian và chi phí | Dữ liệu lỗi thời, không phản ánh thực tế | Cập nhật kho tri thức hàng ngày, không cần huấn luyện lại |
| Tích hợp hệ thống | Khó tích hợp với ERP/CRM, thường thủ công | Dữ liệu phân mảnh, thiếu đồng bộ | Connector chuyên dụng, đồng bộ thời gian thực, phân quyền chặt chẽ |
| Chi phí vận hành | Cao do phải duy trì mô hình và nhân sự chuyên trách | Khó mở rộng, chi phí tăng theo quy mô | Tối ưu hóa caching, lựa chọn mô hình phù hợp, giảm 30-50% chi phí |
Câu hỏi thường gặp
RAG Pipeline khác gì so với việc chỉ sử dụng ChatGPT hay Claude cho doanh nghiệp?
RAG Pipeline truy xuất dữ liệu từ kho tri thức nội bộ của doanh nghiệp trước khi sinh câu trả lời, trong khi ChatGPT hay Claude chỉ dựa vào kiến thức chung của mô hình. Điều này giúp RAG Pipeline cung cấp câu trả lời chính xác hơn, có trích dẫn nguồn và cập nhật theo thời gian thực. Ngoài ra, RAG Pipeline cho phép kiểm soát dữ liệu nhạy cảm không bị gửi ra ngoài, đảm bảo tuân thủ bảo mật.
Chi phí triển khai RAG Pipeline cho doanh nghiệp vừa và nhỏ là bao nhiêu?
Chi phí phụ thuộc vào quy mô dữ liệu, số lượng người dùng và lựa chọn mô hình. Với doanh nghiệp vừa và nhỏ (dưới 200 người dùng), chi phí có thể từ 500-1.500 USD/tháng nếu sử dụng mô hình mã nguồn mở và hạ tầng cloud tối ưu. Uptech cung cấp giải pháp linh hoạt theo ngân sách, giúp doanh nghiệp bắt đầu với chi phí thấp và mở rộng dần.
Làm thế nào để đảm bảo AI Agents không thực hiện hành động sai trái?
Uptech thiết kế AI Agents với guardrails chặt chẽ, bao gồm giới hạn quyền hạn, kiểm tra đầu vào/đầu ra và cơ chế human-in-the-loop cho các hành động quan trọng. Mọi hành động của agent được ghi log và giám sát, cho phép can thiệp kịp thời khi phát hiện bất thường. Doanh nghiệp cũng nên định kỳ đánh giá và cập nhật quy tắc cho agent để phù hợp với thay đổi nghiệp vụ.
RAG Pipeline có thể tích hợp với hệ thống ERP/CRM hiện có của doanh nghiệp không?
Có. Uptech sử dụng kiến trúc dữ liệu phân tán mở với các connector chuyên dụng cho SAP, Salesforce, Oracle và nhiều hệ thống khác. Các connector này đồng bộ dữ liệu theo thời gian thực hoặc theo lô, tuân thủ phân quyền của hệ thống nguồn và mã hóa dữ liệu. Uptech đã triển khai thành công cho nhiều doanh nghiệp với hệ thống ERP/CRM phức tạp.