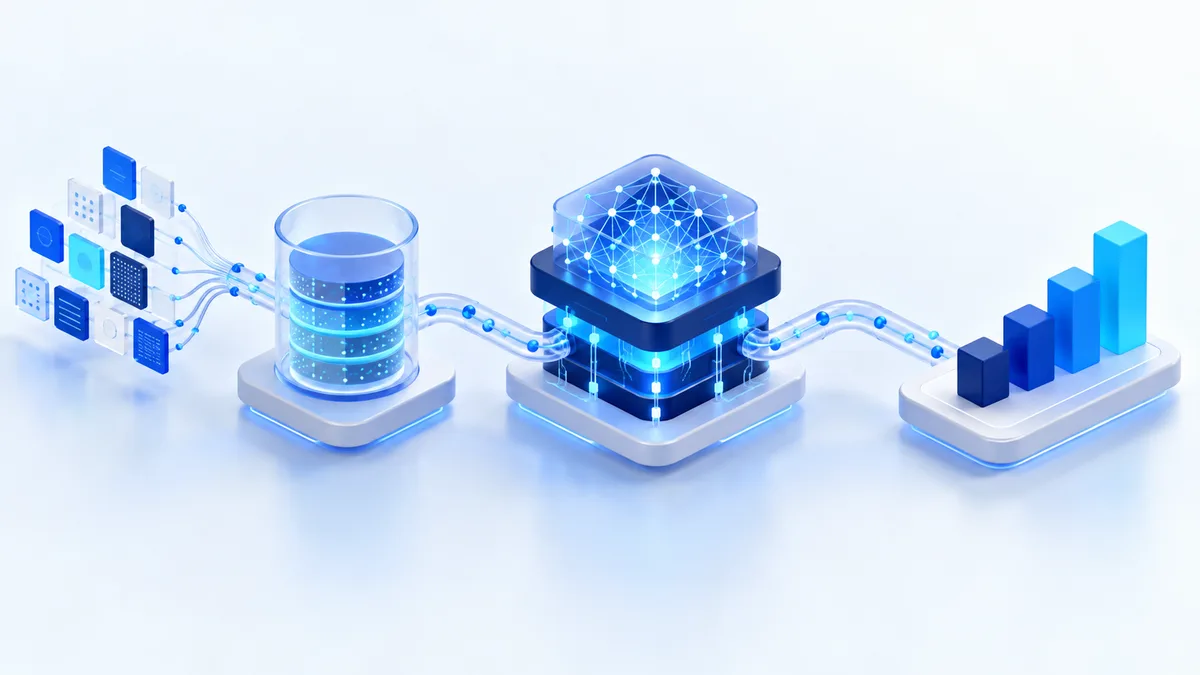
High Availability không chỉ là mục tiêu uptime mà là nền tảng kiến trúc để DevOps & CI/CD tự động hóa vận hành an toàn. Khi kết hợp đúng, doanh nghiệp có thể rút chu kỳ release từ hàng tháng xuống hàng tuần, thậm chí hàng ngày, đồng thời tiết kiệm 25-40% chi phí hạ tầng và giữ cam kết SLA 99.9%.
Trong bối cảnh cạnh tranh số, tốc độ đưa tính năng mới ra thị trường đã trở thành lợi thế sống còn. Tuy nhiên, nhiều doanh nghiệp Việt Nam vẫn mắc kẹt trong vòng lặp release hàng tháng, thậm chí hàng quý, vì lo ngại rủi ro downtime và thiếu niềm tin vào quy trình tự động hóa. Bài phân tích này của Uptech sẽ làm rõ mối quan hệ cộng sinh giữa High Availability và DevOps/CI/CD, đồng thời cung cấp lộ trình thực tế để rút ngắn chu kỳ release mà không đánh đổi độ ổn định hệ thống.
High Availability: Nền tảng kiến trúc cho tốc độ release
High Availability (HA) thường bị hiểu đơn thuần là cam kết uptime 99.9% hay 99.99%. Nhưng ở góc độ kỹ thuật, HA là tập hợp các nguyên tắc thiết kế — dư thừa, phân vùng lỗi, tự phục hồi, cân bằng tải — cho phép hệ thống tiếp tục phục vụ người dùng ngay cả khi một thành phần gặp sự cố. Chính nền tảng này là điều kiện tiên quyết để đội ngũ DevOps tự tin triển khai thường xuyên hơn.
Theo báo cáo của Gartner năm 2024, các tổ chức có kiến trúc HA trưởng thành ghi nhận thời gian downtime trung bình thấp hơn 68% so với nhóm chưa chuẩn hóa. Điều này không chỉ bảo vệ doanh thu mà còn giải phóng áp lực tâm lý cho đội phát triển, tạo điều kiện chuyển dịch từ mô hình release "big bang" sang triển khai nhỏ, liên tục. Khi mỗi thay đổi nhỏ được kiểm soát trong môi trường có khả năng chịu lỗi, rủi ro tổng thể giảm mạnh.
Các trụ cột kỹ thuật của High Availability
Một kiến trúc HA hiện đại dựa trên bốn trụ cột: dư thừa theo vùng (multi-AZ), cân bằng tải thông minh, giám sát và tự động phục hồi, cùng chiến lược sao lưu - phục hồi được kiểm thử định kỳ. Mỗi trụ cột cần được tự động hóa bằng Infrastructure as Code (IaC) để đảm bảo môi trường staging và production luôn đồng nhất. Thiếu bất kỳ trụ cột nào, pipeline CI/CD sẽ dễ dàng tạo ra "single point of failure" ngay trong quá trình triển khai.
Ví dụ, nếu không có cân bằng tải ở tầng ứng dụng, việc triển khai rolling update có thể khiến một phần người dùng nhận lỗi 502 trong vài giây. Ngược lại, khi có load balancer kết hợp health check chặt chẽ, lưu lượng được chuyển hướng sang instance khỏe mạnh trước khi instance cũ bị loại bỏ. Đây là cơ chế then chốt giúp triển khai không downtime — nền tảng của mọi chiến lược release nhanh.
Đánh giá độ trưởng thành HA theo mô hình uptime SLA
Để đo lường mức độ sẵn sàng, doanh nghiệp nên phân loại hệ thống theo mô hình SLA: 99.9% (downtime tối đa khoảng 43 phút/tháng), 99.95% (khoảng 22 phút/tháng) và 99.99% (khoảng 4,3 phút/tháng). Việc xác định đúng mức SLA cho từng dịch vụ giúp tránh đầu tư dư thừa vào các hệ thống không cần độ sẵn sàng cao, đồng thời tập trung nguồn lực cho các luồng nghiệp vụ trọng yếu như thanh toán, xác thực hay đặt hàng.
Uptech khuyến nghị áp dụng mô hình phân tầng: hệ thống core đạt 99.99%, hệ thống hỗ trợ đạt 99.9%, hệ thống nội bộ có thể chấp nhận 99.5%. Cách phân tầng này giúp tối ưu chi phí hạ tầng đáng kể, bởi chi phí để tăng từ 99.9% lên 99.99% thường tăng theo cấp số nhân. Đây cũng là nguyên tắc cốt lõi trong dịch vụ Hạ tầng Cloud & FinOps mà Uptech triển khai cho khách hàng.
DevOps & CI/CD tự động hóa: Từ lý thuyết đến thực chiến
DevOps không phải là công cụ mà là văn hóa kết hợp quy trình và công nghệ. Trong đó, CI/CD (Continuous Integration/Continuous Delivery) là xương sống kỹ thuật, cho phép tích hợp mã nguồn liên tục và tự động hóa kiểm thử, triển khai. Khi được thiết kế đúng, pipeline CI/CD giảm thiểu thao tác thủ công, loại bỏ lỗi con người và tăng tốc độ phản hồi với thị trường.
Theo khảo sát DORA 2024, các tổ chức thuộc nhóm "elite" có thể triển khai nhiều lần mỗi ngày với thời gian phục hồi sự cố dưới một giờ. Khoảng cách giữa nhóm elite và nhóm thấp nhất lên tới hàng trăm lần về tần suất triển khai. Điều đáng chú ý là nhóm elite không hề có tỷ lệ lỗi cao hơn; ngược lại, họ thường có change failure rate thấp hơn nhờ tự động hóa kiểm thử và triển khai theo từng bước nhỏ.
Kiến trúc pipeline CI/CD chuẩn cho doanh nghiệp Việt
Một pipeline CI/CD hiệu quả cần bao gồm các giai đoạn: kiểm tra mã nguồn (lint, static analysis), build, kiểm thử tự động (unit, integration, security scan), đóng gói artifact, triển khai lên staging và cuối cùng là production với chiến lược canary hoặc blue-green. Mỗi giai đoạn cần có quality gate rõ ràng, tự động chặn nếu phát hiện lỗi nghiêm trọng. Việc này đảm bảo không có thay đổi rủi ro nào lọt qua mà không được kiểm soát.
Tại Uptech, chúng tôi thường thiết kế pipeline theo mô hình "fail fast" — kiểm tra các lỗi phổ biến ngay từ giai đoạn đầu để tiết kiệm thời gian và chi phí compute. Các công cụ như GitLab CI, GitHub Actions, Jenkins hay ArgoCD được lựa chọn tùy theo hạ tầng hiện hữu. Điểm quan trọng là pipeline phải được định nghĩa dưới dạng mã (pipeline-as-code) và lưu trữ cùng kho mã nguồn, giúp dễ dàng audit và tái sử dụng.
Chuyển dịch từ release hàng tháng sang hàng tuần
Quá trình chuyển dịch cần được thực hiện theo từng bước, tránh "big bang". Giai đoạn đầu, doanh nghiệp nên tự động hóa khâu build và kiểm thử, sau đó mới tự động hóa triển khai lên staging. Khi đội ngũ đã quen với nhịp độ mới, tiến tới tự động hóa production với các chiến lược triển khai an toàn. Mỗi bước cần có số liệu đo lường cụ thể như lead time, deployment frequency, change failure rate và MTTR.
Một khách hàng của Uptech trong lĩnh vực thương mại điện tử đã rút chu kỳ release từ 6 tuần xuống 1 tuần trong vòng 4 tháng, nhờ áp dụng pipeline CI/CD kết hợp kiến trúc HA đa vùng. Số liệu ghi nhận: deployment frequency tăng 6 lần, change failure rate giảm từ 18% xuống 4%, MTTR giảm từ 4 giờ xuống 35 phút. Đây là minh chứng cho thấy tốc độ và độ ổn định có thể song hành nếu kiến trúc được thiết kế đúng.
Tối ưu và đồng hành cùng chuyên gia Uptech
Uptech cung cấp dịch vụ Hạ tầng Cloud & FinOps trọn gói, cam kết SLA và tối ưu chi phí vận hành.
Nhận tư vấn giải pháp
Chiến lược triển khai không downtime với High Availability
Triển khai không downtime là mục tiêu của mọi đội DevOps, nhưng để đạt được cần sự kết hợp của nhiều yếu tố: kiến trúc ứng dụng stateless, cơ chế health check chính xác, và chiến lược chuyển đổi lưu lượng thông minh. Khi hệ thống có HA, việc triển khai phiên bản mới có thể diễn ra song song với phiên bản cũ, giảm thiểu rủi ro và cho phép rollback nhanh chóng nếu phát hiện bất thường.
Các chiến lược phổ biến bao gồm blue-green deployment, canary release và rolling update. Mỗi chiến lược có ưu nhược điểm riêng về chi phí, độ phức tạp và mức độ rủi ro. Việc lựa chọn phụ thuộc vào đặc thù nghiệp vụ, ngân sách và mức độ trưởng thành của đội ngũ. Dưới đây là bảng so sánh chi tiết giúp doanh nghiệp ra quyết định phù hợp.
| Tiêu chí | Mô hình truyền thống | Thách thức thường gặp | Giải pháp khuyến nghị (Uptech) |
|---|---|---|---|
| Chiến lược triển khai | Big bang, downtime theo lịch | Rủi ro cao, ảnh hưởng người dùng | Blue-green hoặc canary với HA đa vùng |
| Tần suất release | Hàng tháng hoặc hàng quý | Chậm phản hồi thị trường | Hàng tuần hoặc hàng ngày, tự động hóa |
| Kiểm thử | Thủ công, cuối chu kỳ | Tốn thời gian, dễ bỏ sót lỗi | Tự động hóa unit, integration, security scan |
| Giám sát | Phản ứng khi có sự cố | MTTR cao, khó truy vết | Observability toàn diện, alert tự động |
| Chi phí hạ tầng | Dư thừa tĩnh, lãng phí | Khó tối ưu theo nhu cầu | Auto-scaling kết hợp FinOps, tiết kiệm 25-40% |
| Cam kết SLA | Không rõ ràng hoặc thấp | Mất uy tín với khách hàng | SLA 99.9% có giám sát và báo cáo định kỳ |
Blue-Green và Canary Release: Khi nào nên dùng?
Blue-Green deployment duy trì hai môi trường song song, cho phép chuyển đổi lưu lượng tức thời từ môi trường cũ sang môi trường mới. Ưu điểm là rollback gần như tức thì, nhưng chi phí hạ tầng tăng gấp đôi trong thời gian chuyển đổi. Chiến lược này phù hợp với các hệ thống có lưu lượng lớn nhưng ít thay đổi cấu trúc dữ liệu, hoặc các dịp cao điểm cần đảm bảo không gián đoạn.
Canary release lại chuyển dần một phần nhỏ lưu lượng (thường 1-5%) sang phiên bản mới, theo dõi các chỉ số lỗi và hiệu năng trước khi mở rộng. Cách này tiết kiệm chi phí hơn và phát hiện sớm vấn đề trong môi trường thực tế. Tuy nhiên, nó đòi hỏi hệ thống observability mạnh và khả năng định tuyến lưu lượng linh hoạt. Uptech thường khuyến nghị canary cho các dịch vụ microservices có tần suất thay đổi cao.
Vai trò của Observability và tự động rollback
Observability không chỉ là logging hay monitoring mà là khả năng hiểu sâu trạng thái hệ thống thông qua metrics, logs và traces. Khi kết hợp với CI/CD, observability trở thành "cảm biến" để tự động quyết định rollback nếu phát hiện bất thường. Ví dụ, nếu tỷ lệ lỗi HTTP 5xx tăng vượt ngưỡng trong 2 phút sau triển khai, hệ thống có thể tự động chuyển lưu lượng về phiên bản cũ mà không cần can thiệp thủ công.
Để làm được điều này, doanh nghiệp cần thiết lập SLO (Service Level Objectives) rõ ràng và error budget. Khi error budget cạn kiệt, đội ngũ buộc phải tạm dừng triển khai tính năng mới để tập trung khắc phục độ ổn định. Đây là cơ chế cân bằng giữa tốc độ và chất lượng, được các tổ chức công nghệ hàng đầu áp dụng rộng rãi.
Bài toán chi phí FinOps trong kỷ nguyên release nhanh
Tăng tần suất release đồng nghĩa với việc hạ tầng phải co giãn linh hoạt hơn, dễ dẫn đến chi phí cloud tăng nếu không được kiểm soát. FinOps — bộ nguyên tắc quản trị tài chính cloud — giúp doanh nghiệp cân bằng giữa tốc độ, độ ổn định và chi phí. Mục tiêu không phải là cắt giảm tối đa mà là tối ưu hóa giá trị trên mỗi đồng chi tiêu.
Theo báo cáo State of Cloud của Flexera 2024, các tổ chức lãng phí trung bình 27% chi phí cloud do tài nguyên nhàn rỗi và thiếu giám sát. Trong môi trường CI/CD, các môi trường tạm thời (ephemeral environments) cho testing có thể trở thành nguồn lãng phí lớn nếu không được dọn dẹp tự động. Việc áp dụng tagging, budget alert và auto-scaling chính sách là những bước cơ bản để kiểm soát.
Tối ưu 25-40% chi phí hạ tầng: Cách Uptech thực hiện
Uptech đã giúp nhiều khách hàng đạt mức tiết kiệm 25-40% chi phí hạ tầng cloud thông qua quy trình FinOps bài bản. Quy trình bắt đầu bằng việc phân tích chi tiêu chi tiết theo dịch vụ, team và môi trường, sau đó xác định các nguồn lãng phí như instance over-provisioned, storage không dùng đến, hay reserved instance chưa được tận dụng. Tiếp theo là thiết lập chính sách auto-scaling, right-sizing và lịch tắt môi trường dev/test ngoài giờ làm việc.
Một khách hàng trong lĩnh vực tài chính của Uptech đã giảm 32% chi phí cloud hàng tháng sau 3 tháng triển khai FinOps, trong khi vẫn tăng tần suất release lên gấp 4 lần. Bí quyết nằm ở việc kết hợp auto-scaling với kiến trúc HA, đảm bảo hệ thống tự động mở rộng khi lưu lượng tăng và thu hẹp khi giảm, tránh lãng phí tài nguyên. Đồng thời, việc sử dụng spot instance cho các workload không yêu cầu SLA cao cũng mang lại tiết kiệm đáng kể.
Đánh đổi giữa tốc độ và chi phí: Ma trận quyết định
Không có giải pháp nào phù hợp cho mọi doanh nghiệp. Việc lựa chọn mức độ đầu tư vào HA và tự động hóa phụ thuộc vào quy mô, ngành nghề và mức độ chấp nhận rủi ro. Các doanh nghiệp trong lĩnh vực thanh toán, y tế cần ưu tiên HA cao và có thể chấp nhận chi phí lớn hơn. Trong khi đó, các startup giai đoạn đầu có thể bắt đầu với mức HA vừa phải và tăng dần khi quy mô mở rộng.
Uptech khuyến nghị xây dựng ma trận quyết định dựa trên ba trục: tác động downtime đến doanh thu, tần suất thay đổi nghiệp vụ và ngân sách hạ tầng. Từ đó, xác định mức SLA mục tiêu, chiến lược triển khai và mức độ tự động hóa phù hợp. Cách tiếp cận này giúp tránh đầu tư dàn trải hoặc bỏ qua các rủi ro trọng yếu.
Lộ trình triển khai thực tế tại doanh nghiệp
Việc chuyển đổi từ release hàng tháng sang hàng tuần không thể diễn ra trong một sớm một chiều. Nó đòi hỏi sự thay đổi về văn hóa, quy trình và công nghệ, cùng với cam kết từ ban lãnh đạo. Một lộ trình thực tế thường kéo dài từ 3 đến 6 tháng, chia thành các giai đoạn rõ ràng với mục tiêu đo lường được.
Giai đoạn 1 (tháng 1-2): Đánh giá hiện trạng, xây dựng pipeline CI cơ bản, tự động hóa build và unit test. Giai đoạn 2 (tháng 3-4): Triển khai CD lên staging, thiết lập kiến trúc HA cơ bản với multi-AZ và load balancing. Giai đoạn 3 (tháng 5-6): Tự động hóa production với canary/blue-green, thiết lập observability và FinOps. Sau mỗi giai đoạn, đo lường các chỉ số DORA để đánh giá tiến độ và điều chỉnh.
Các yếu tố thành công và rủi ro cần tránh
Yếu tố thành công quan trọng nhất là sự đồng thuận giữa đội phát triển, vận hành và bảo mật. DevOps không thể thành công nếu các nhóm làm việc trong silo. Việc thiết lập cross-functional team, chia sẻ trách nhiệm về uptime và khuyến khích văn hóa blameless post-mortem là nền tảng để cải tiến liên tục. Bên cạnh đó, đầu tư vào đào tạo và công cụ phù hợp cũng không thể thiếu.
Rủi ro thường gặp bao gồm: tự động hóa quá sớm khi quy trình chưa ổn định, thiếu giám sát dẫn đến sự cố khó truy vết, và bỏ qua khía cạnh bảo mật trong pipeline. Uptech khuyến nghị áp dụng nguyên tắc "security shift-left" — tích hợp kiểm tra bảo mật ngay từ giai đoạn phát triển, thay vì để đến cuối. Đồng thời, cần có kế hoạch rollback rõ ràng cho mọi thay đổi quan trọng.
Vai trò đối tác Managed Services như Uptech
Với các doanh nghiệp thiếu nguồn lực chuyên sâu về DevOps và cloud, việc hợp tác với đối tác Managed Services giúp rút ngắn thời gian triển khai và giảm rủi ro. Uptech cung cấp dịch vụ Hạ tầng Cloud & FinOps trọn gói, từ tư vấn kiến trúc, triển khai pipeline CI/CD, đến vận hành và giám sát 24/7 với cam kết SLA 99.9%. Đội ngũ chuyên gia của Uptech đã đồng hành cùng nhiều doanh nghiệp Việt Nam trong hành trình chuyển đổi số.
Dịch vụ của Uptech không chỉ dừng ở việc thiết lập hạ tầng mà còn bao gồm tối ưu chi phí định kỳ, báo cáo minh bạch và chuyển giao kiến thức cho đội ngũ nội bộ. Chúng tôi tin rằng đối tác tốt là người giúp khách hàng tự chủ và phát triển bền vững, không phải phụ thuộc lâu dài. Quý doanh nghiệp quan tâm có thể liên hệ Uptech để được tư vấn lộ trình phù hợp.
Câu hỏi thường gặp
High Availability khác gì so với Disaster Recovery?
High Availability tập trung vào việc đảm bảo hệ thống liên tục hoạt động trong điều kiện lỗi cục bộ như hỏng server, mất kết nối một vùng. Disaster Recovery xử lý các sự cố quy mô lớn như thiên tai, mất toàn bộ trung tâm dữ liệu, với mục tiêu khôi phục sau thảm họa. Hai khái niệm bổ trợ nhau: HA giảm thiểu gián đoạn hàng ngày, DR đảm bảo khả năng phục hồi khi thảm họa xảy ra. Một kiến trúc trưởng thành cần cả hai.
Làm thế nào để đo lường hiệu quả của DevOps và CI/CD?
Doanh nghiệp nên theo dõi bốn chỉ số DORA: deployment frequency (tần suất triển khai), lead time for changes (thời gian từ commit đến production), change failure rate (tỷ lệ thay đổi gây lỗi) và MTTR (thời gian phục hồi trung bình). Ngoài ra, có thể bổ sung các chỉ số về chi phí hạ tầng và mức độ hài lòng của đội ngũ. Việc đo lường định kỳ giúp xác định điểm nghẽn và ưu tiên cải tiến.
Chi phí để đạt SLA 99.9% có quá cao với doanh nghiệp vừa và nhỏ?
Không nhất thiết. Với kiến trúc cloud hiện đại và các dịch vụ managed, chi phí để đạt 99.9% đã giảm đáng kể so với trước đây. Doanh nghiệp có thể bắt đầu với multi-AZ, load balancing và auto-scaling — những thành phần cơ bản với chi phí hợp lý. Uptech đã giúp nhiều khách hàng SME đạt SLA 99.9% trong khi tối ưu 25-40% chi phí hạ tầng nhờ áp dụng FinOps đúng cách.
Uptech hỗ trợ doanh nghiệp chuyển đổi DevOps như thế nào?
Uptech cung cấp dịch vụ tư vấn và triển khai trọn gói: đánh giá hiện trạng, thiết kế kiến trúc HA, xây dựng pipeline CI/CD, thiết lập observability và FinOps. Đội ngũ chuyên gia của Uptech đồng hành từ giai đoạn lập kế hoạch đến vận hành, với cam kết SLA 99.9% và báo cáo minh bạch. Doanh nghiệp có thể bắt đầu bằng một buổi đánh giá miễn phí để xác định lộ trình phù hợp.